
Clientbase GPT
Смотрите также другие видео по дополнительным опциям.
Общая информация
Тарифная опция "Clientbase GPT" позволяет интегрировать функционал искусственного интеллекта прямо в вашу таблицу. Пишете вопрос в одном поле — получаете ответ ИИ в другом. Ответ может быть в виде текста, изображения или файла формата "docx".
Например, есть задача формировать описание коммерческого предложения с помощью ИИ на основе текста заявки клиента.
Технические детали
-
Доступно с версии 3.0.5.
-
Тарифную опцию нельзя отключить до конца срока действия лицензии, либо в течение первых 30 дней для SAAS аккаунтов. После подключения опции дополнительной оплаты не потребуется, но общий срок действия вашего аккаунта будет пересчитан в меньшую сторону в соответствии со стоимостью выбранной опции.
-
Доступно на всех тарифах, кроме "Free" (тариф "Free" действует для аккаунтов с тестовым периодом).
Как подключить Clientbase GPT
Активируйте тарифную опцию «Clientbase GPT» в личном кабинете.
Доступны два варианта:
- Clientbase GPT - использование моделей и токенов, предоставляемых в рамках тарифной опции Clientbase GPT. Количество доступных токенов зависит от выбранного тарифа (GPT 1, GPT 2, ..).
- Свой GPT - использование собственных API-ключей OpenAI и/или Yandex. В этом случае запросы выполняются за счет ресурсов пользователя, а токены расходуются на стороне соответствующего сервиса. Опция доступна начиная с ревизии 23439.
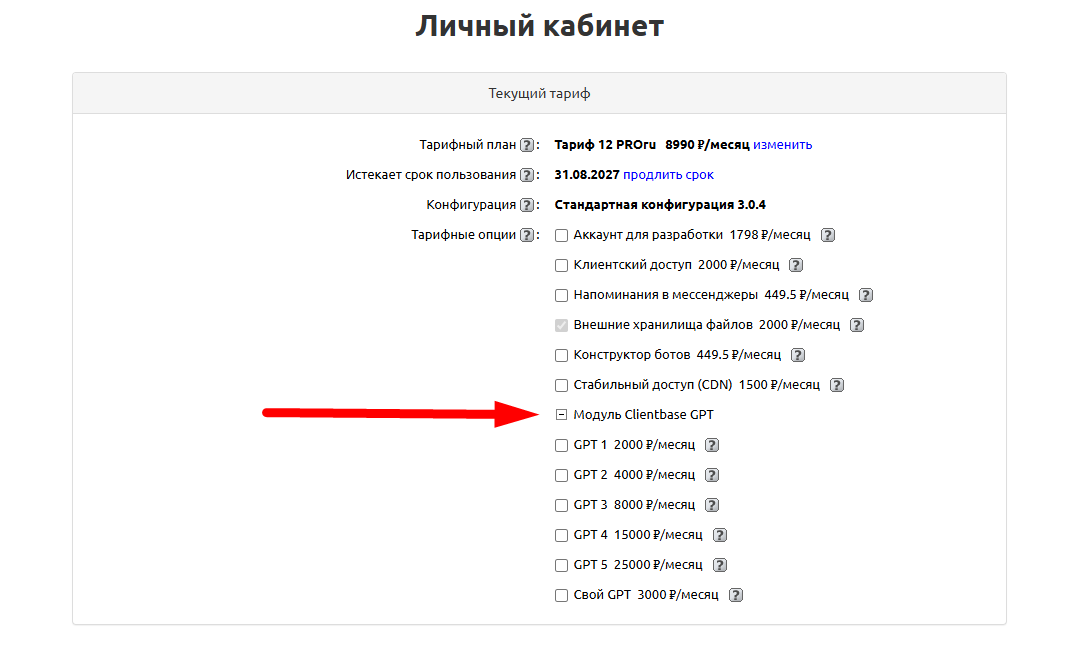
После подключения нужной тарифной опции в личном кабинете перейдите в разделе «Модули» -> «Маркетплейс» и включите модуль «Интеграция с Clientbase GPT».
Свой GPT
Если в личном кабинете подключена тарифная опция «Свой GPT», во вкладке «Подключение» выберите режим работы «Свой ключ».
После выбора режима появятся поля для подключения собственных сервисов:
- API-ключ OpenAI - ключ для подключения моделей OpenAI.
- API-ключ Yandex - ключ для подключения моделей Yandex.
- Folder ID Yandex - идентификатор каталога Yandex, необходимый для работы с API Yandex.
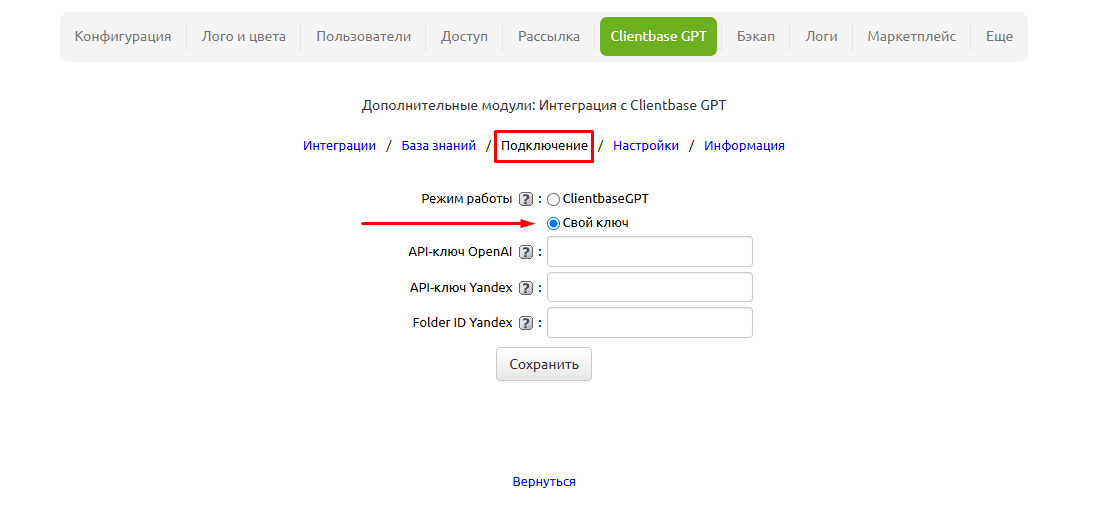
Можно подключить только OpenAI, только Yandex или одновременно оба сервиса. После заполнения необходимых параметров нажмите «Сохранить».
При использовании режима «Свой ключ» запросы к выбранным нейросетям выполняются с использованием API-ключей пользователя. Расход токенов и ресурсов учитывается на стороне соответствующего сервиса и не списывается из лимита токенов Clientbase GPT.
Важно! Тарифная опция «Свой GPT» доступна начиная с ревизии 23439.
Создание интеграции и заполнение параметров настройки
Для создания интеграции нажмите "Добавить интеграцию" во вкладке "Интеграции" и заполните параметры настройки:
Название - введите интуитивно понятное название шаблона запроса
Тип обработки - вариант "Отложенная обработка (по cron)" рекомендуем использовать, если ответ не требуется немедленно. В остальных случаях выбирайте "Сразу после получения запроса"
Таблица КБ - выберите таблицу, из которой будут браться поля для входных/выходных данных
Тип работы - выберите параметр, который будет определять формат входных данных (запроса) и выходных данных (ответа) при взаимодействии с Clientbase GPT.
Доступные варианты (подробнее рассмотрим далее):
- Текст - Текст
- Текст - Изображение
- Изображение - Текст
- Изображение - Изображение
- Текстовый файл - Текст
- Текст - Текстовый файл
- Текстовый файл - Текстовый файл
- Word docx - Текст
- Word docx - Word docx
- Текст - PDF
- PDF - Текст
- PDF - PDF
- Аудио - Текст
- Текст - Аудио
- Текст - Добавление строк
- Текст - Заполнение записи
- Текст - Excel
- Excel - Текст
- Excel - Excel
Провайдер нейросети - выберите поставщика ИИ-модели.
Доступные варианты:
- OpenAI - широкий выбор моделей для генерации текста, изображений и аудио, подходит для большинства международных сценариев использования.
- Yandex - модели Яндекс для генерации и анализа текста, хорошо подходят для локальных бизнес-задач, работы с русскоязычными данными и корпоративных сценариев.
Языковая модель - выберите подходящую модель в зависимости от требуемого качества, скорости и стоимости обработки.
Для OpenAI:
- высокоуровневые модели (GPT-5.6 Sol / GPT-5.4 / GPT-5.2 / GPT-5 / GPT-4o / tts-1-hd) — максимальное качество генерации, аналитики и понимания контекста;
- сбалансированные модели (GPT-5.6 Terra / GPT-5.4-mini / GPT-5-mini / GPT-4.1-mini / GPT-4o-mini / tts-1) — хороший баланс между качеством, скоростью и стоимостью;
- бюджетные модели (GPT-5.6 Luna / GPT-5.4-nano/ GPT-5-nano / GPT-4.1-nano) — подходят для простых массовых задач, где важна минимальная стоимость обработки.
Для Yandex:
- YandexGPT 5 Lite — быстрая и экономичная модель для повседневных задач, простых диалогов и базовой генерации текста;
- YandexGPT 5 Pro / YandexGPT 5.1 Pro / Alice AI LLM — продвинутые модели для сложных запросов, аналитики, генерации контента и более качественной работы с русскоязычными текстами.
Сообщение - введите запрос (промпт) для ИИ. Текст запроса может состоять
- из текста со вставкой одного или нескольких полей (переменных) выбранной таблицы
- из поля (переменной) выбранной таблицы. В этом случае предполагается, что запрос к ИИ содержится в значении поля. Это расширяет возможности, так как значение поля может формироваться с использованием функционала Кб (вычислений, правил и др.)
Доступные предустановленные промпты
Для вашего удобства в системе доступна библиотека готовых промптов, оптимизированных под типовые бизнес-задачи. Вы можете выбрать один из них в выпадающем списке :

Важно! Чем точнее будет запрос, тем меньше времени потребуется искусственному интеллекту на его обработку и тем более точный ответ вы получите
Статус - выберите поле типа «текст», в которое будет записан статус обработки запроса.
Для работы с изображениями:
Ориентация изображения - выберите формат (соотношение сторон) для генерируемого изображения. Доступные варианты:
- Квадрат - классический формат 1:1 (1024x1024 пикселей).
- Ландшафт - горизонтальное изображение (1792x1024 пикселей).
- Портрет - вертикальное изображение (1024x1792 пикселей).
Модель - выберите модель для генерации изображения.
Доступные варианты:
- GPT Image 1.5 Low - базовая модель. Оптимальна для быстрой генерации простых изображений по низкой стоимости.
- GPT Image 1.5 Medium - сбалансированная модель. Рекомендуется для большинства задач, обеспечивая хорошее качество деталей.
- GPT Image 1.5 High - продвинутая модель. Максимальное качество и детализация изображения, подходит для сложных и реалистичных запросов.
- DALL·E 3 Standard (устаревшая модель) - предыдущая версия модели от OpenAI. Не рекомендуется для новых проектов, так как выведена из активной разработки и поддержки. Доступна для обеспечения обратной совместимости с ранее созданными процессами.
Далее рассмотрим параметры, которые появляются после выбора типа работы.
Тип работы "Текст - Текст"
Ответ - выберите поле, в которое будет помещен ответ GPT. Используйте тип поля "текст" с включенным чекбоксом "Многострочное".
Тип работы "Текст - Изображение"
Файл в ответе - выберите поле, в которое будет помещено изображение, сформированное искусственным интеллектом. Используйте тип поля "изображение" или "файл".
На текущий момент поддерживается создание только одного изображения в поле
Наименование файла - укажите название файла.
Тип работы "Изображение - Текст"
При выборе этого типа интеграции вы можете отправлять изображения из вашей таблицы в нейросеть и получать текстовый ответ по содержимому картинки. Модуль распознает объекты, сцены, текст на изображениях, а также отвечает на вопросы, связанные с визуальным контентом.
Изображение - выберите поле таблицы, из которого будет браться изображение для анализа. Поле должно быть типа «Изображение» или «Файл». Поле может содержать несколько изображений, Clientbase GPT проанлизирует все изображения в этом поле.
Ответ - выберите поле, в которое будет помещен ответ GPT. Используйте тип поля «текст» с включенным чекбоксом «Многострочное».
Тип работы «Изображение - Изображение»
Изображение - выберите поле таблицы, в которое будет загружено исходное изображение для анализа.
Поле должно быть типа «Изображение» или «Файл».
Файл в ответе - выберите поле таблицы, в которое будет помещено сгенерированное изображение.
Используйте поле типа «Изображение» или «Файл».
Тип работы "Текстовый файл - Текст"
Текстовый файл источник - выберите поле. Поле должно быть типа "файл". Поле может содержать несколько файлов, Clientbase GPT проанлизирует все файлы в этом поле.
Текстовый ответ - выберите поле, в которое будет помещен ответ GPT. Используйте тип поля "текст" с включенным чекбоксом "Многострочное".
Тип работы “Текст - Текстовый файл”
Файл в ответе - выберите поле, в которое будет помещен текстовый файл, сформированный искусственным интеллектом. Используйте тип поля "файл".
Наименование файла - укажите название файла.
Тип работы "Текстовый файл - Текстовый файл"
Текстовый файл источник - выберите поле таблицы, из которого будет браться текстовый файл для обработки. Поле должно быть типа "файл".
Текстовый файл источник 2 - при необходимости можно указать дополнительное поле таблицы, из которого также будет браться файл для обработки. Поле должно быть типа "файл".
Файл в ответе - выберите поле таблицы, в которое будет помещен новый текстовый файл, сформированный искусственным интеллектом. Используйте поле типа "файл".
Тип работы "Word docx - Текст"
Текстовый файл источник - выберите поле. Поле должно быть типа "файл"
Текстовый ответ - выберите поле, в которое будет помещен ответ GPT. Используйте тип поля "текст" с включенным чекбоксом "Многострочное"
Тип работы "Word docx - Word docx"
Текстовый файл источник - выберите поле. Поле должно быть типа "файл"
Файл получатель - выберите поле, в которое будет помещен файл с ответом GPT. Используйте тип поля "файл"
Тип работы "Текст - PDF"
Файл в ответе - выберите поле, в которое будет помещен PDF-файл, сформированный искусственным интеллектом. Используйте поле типа «Файл».
Наименование файла - укажите название создаваемого PDF-файла.
Тип работы "PDF - Текст"
Текстовый файл источник - выберите поле таблицы, из которого будет браться PDF-документ для анализа. Поле должно быть типа «Файл».
Текстовый ответ - выберите поле, в которое будет помещен ответ GPT. Используйте тип поля «Текст» с включенным чекбоксом «Многострочное».
Тип работы "PDF - PDF"
Текстовый файл источник - выберите поле таблицы, из которого будет браться PDF-документ для анализа. Поле должно быть типа «Файл».
Файл получатель - выберите поле таблицы, в которое будет помещен новый PDF-документ, сформированный искусственным интеллектом. Используйте поле типа «Файл».
Тип работы “Аудио - Текст”
Аудио файл источник - выберите поле. Поле должно быть типа “файл”.
Текстовый ответ - выберите поле, в которое будет помещен ответ GPT. Используйте тип поля "текст" с включенным чекбоксом "Многострочное".
В настройках типа запроса предусмотрен параметр 'Язык аудио', который необходимо указать для корректного распознавания языка в загружаемом аудиофайле.
Тип работы “Текст - Аудио”
Файл в ответе - выберите поле, в которое будет помещен аудио файл, сформированный искусственным интеллектом. Используйте тип поля "файл".
Наименование файла - укажите название файла
Также в настройка типа запроса вы можете настроить поле “Голос” и поле “Язык”, выбрав подходящий вариант.
Примеры голосов
- Jhon (мужской). Гладкий, уверенный голос (универсален, подходит для презентаций и справки)
- Merry (женский). Чёткий и профессиональный (если нужен дружелюбный, "человеческий" стиль)
- Jhon (мужской). Тёплый, сказочный, выразительный (формальный стиль, хорош для инструкций)
- Jhon (мужской). Глубокий, серьёзный, баритональный (рассказчики, storytelling)
- Jhon (мужской). Живой, энергичный и дружелюбный (подходит для обучающих видео и официальных объявлений)
- Merry (женский). Лёгкий, воздушный, с эмоциональным тоном (если нужен дружелюбный, "человеческий" стиль)
Тип работы "Текст - Добавление строк"
Данный тип интеграции позволяет на основе текстового промпта (запроса) не только сгенерировать структурированные данные, но и автоматически добавить их в виде новых записей в указанную таблицу/подтаблицу вашей системы. Это идеально подходит для задач массового создания карточек, компаний, товаров и любых других данных по описанию.
Текстовый запрос — введите промпт, который описывает, какие данные необходимо сгенерировать и добавить. Например: "Создай 10 записей для базы поставщиков кофе. Для каждой укажи название компании, страну происхождения, контактный email и рейтинг от 1 до 5."
Файл в ответе — выберите поле типа "файл", в которое будет помещен текстовый файл со сгенерированной информацией. Это позволяет сохранить полный ответ системы в удобном для чтения и архивации виде.
Таблица для добавления записей — выберите таблицу, в которую будут автоматически добавлены новые записи. Система самостоятельно проведет сопоставление: данные из ответа GPT будут размещены в поля таблицы с соответствующими названиями (например, "Название компании" -> "Название", "email" -> "Почта").
Поля - выберите поля таблицы, которые будут заполнены при добавлении записи.

Тип работы "Текст - Заполнение записи"
Поле 1 - Поле 20 - выберите поля таблицы, которые необходимо автоматически заполнить на основе анализа текста.
Лимит символов по полям - максимальное количество символов из полей типа «Связь» , которое будет отправлено в нейросеть.
Данная настройка становится доступна при подключении базы знаний и предназначена для разделения небольших и объёмных данных, получаемых через поля типа «Связь». Если объём данных, полученных по значениям поля связи, не превышает установленный лимит, они передаются в нейросеть целиком. Если объём превышает лимит, такие данные считаются объёмными и не включаются напрямую в запрос, а могут использоваться через механизм базы знаний.
По умолчанию рекомендуется использовать значение не менее 1000 символов. Это позволяет автоматически передавать в нейросеть небольшие данные из связанных записей и одновременно исключать из запроса большие тексты, которые могут значительно увеличивать расход токенов.
Не рекомендуется устанавливать слишком маленькое значение лимита, так как в этом случае из запроса могут быть исключены даже небольшие по содержанию поля типа «Связь», что может ухудшить качество ответа нейросети.
Важно! Общий объём данных, передаваемых в ИИ, ограничен 500 000 символов. В этот объём входит текст запроса (промпт), а также все дополнительные данные, включая значения из полей с выбором (например, поля связи, списки и другие).
После сохранения настроек модуля в настройках таблицы будет создано новое вычисление (в настройки вычисления можно будет перейти по ссылке, которая появится ниже).
Важно! По умолчанию, вычисление будет срабатывать при добавлении новой записи или сохранении записи при редактировании. Вы можете поменять действие для запуска, а также другие настройки вычисления. Также вы можете изменить порядок выполнения вычисления, перетащив вычисление выше или ниже в списке вычислений. Не рекомендуется удалять созданное вычисление, чтобы не нарушать логику работы модуля.
Тип работы "Текст - Excel"
Файл получатель - выберите поле, в которое будет помещен Excel-файл, сформированный искусственным интеллектом. Используйте поле типа «Файл».
Наименование файла - укажите название создаваемого файла.
Тип работы "Excel - Текст"
Excel-файл источник - выберите поле таблицы, из которого будет браться Excel-файл для анализа. Поле должно быть типа «Файл».
Текстовый ответ - выберите поле, в которое будет помещен ответ GPT. Используйте тип поля «Текст» с включенным чекбоксом «Многострочное».
Тип работы "Excel - Excel"
Excel-файл источник - выберите поле таблицы, из которого будет браться Excel-файл для анализа. Поле должно быть типа «Файл».
Файл получатель - выберите поле таблицы, в которое будет помещен новый Excel-файл, сформированный искусственным интеллектом. Используйте поле типа «Файл».
Форматы входных и выходных данных
Текст → Текст
Входные данные: Текстовый запрос.
Выходные данные: Ответ в виде текста.
Пример использования: Пользователь вводит текстовый вопрос, система возвращает текстовый ответ.
Текст → Изображение
Входные данные: Текстовый запрос (например, описание для генерации изображения).
Выходные данные: Ответ в виде изображения (например, сгенерированная картинка).
Пример использования: Запрос "Нарисуй кота в шляпе", система возвращает изображение кота в шляпе.
Изображение → Изображение
Входные данные: Изображение и текстовый запрос.
Выходные данные: Новое изображение.
Пример использования: Пользователь загружает изображение и указывает текстовый запрос с описанием изменений (например: «Сделай фон ночным и добавь неоновую подсветку»). Система анализирует исходное изображение и генерирует новое изображение с учетом указанного описания.
Текстовый файл → Текст
Входные данные: Запрос в виде текстового файла (.txt).
Выходные данные: Ответ в виде текста.
Пример использования: Пользователь загружает .txt-файл с вопросом, система обрабатывает его и возвращает текстовый ответ.
Текст → Текстовый файл
Входные данные: Текстовый запрос.
Выходные данные: Ответ в виде текстового файла (.txt)
Пример использования: Запрос “Проанализируй текст из поля {Комментарий к клиенту} и выдели ключевые моменты: контактные лица, проблемы, пожелания.” , система возвращает структурированный файл с ключевой информацией.
Текстовый файл → Текстовый файл
Входные данные: Один или несколько текстовых файлов (.txt).
Выходные данные: Новый текстовый файл (.txt), сформированный искусственным интеллектом.
Пример использования: Пользователь загружает один или несколько текстовых файлов, например черновик договора и дополнительное описание проекта. Искусственный интеллект анализирует содержимое документов, исправляет ошибки, структурирует информацию или объединяет данные из всех файлов и возвращает новый текстовый файл с обработанным результатом.
Word docx → Текст
Входные данные: Запрос в виде документа Word (.docx).
Выходные данные: Ответ в виде текста.
Пример использования: Пользователь загружает .docx-файл, система извлекает текст, обрабатывает его и возвращает текстовый ответ.
Word docx → Word docx
Входные данные: Документ Word (.docx).
Выходные данные: Ответ в виде модифицированного документа Word (.docx).
Пример использования: Пользователь загружает .docx-файл, система анализирует его, вносит изменения (например, добавляет комментарии или исправления) и возвращает новый .docx-файл.
Текст → PDF
Входные данные: Текстовый запрос.
Выходные данные: PDF-документ.
Пример использования: Пользователь вводит запрос «Сформируй коммерческое предложение для клиента на основании следующих данных...». Система генерирует оформленный PDF-документ, который можно отправить клиенту или сохранить в системе.
PDF → Текст
Входные данные: PDF-документ.
Выходные данные: Ответ в виде текста.
Пример использования: Пользователь загружает PDF-файл с договором, отчетом или инструкцией. Система анализирует содержимое документа и возвращает текстовый ответ, краткое содержание, список замечаний либо отвечает на поставленные вопросы по документу.
PDF → PDF
Входные данные: Один или несколько PDF-документов.
Выходные данные: Новый PDF-документ.
Пример использования: Пользователь загружает PDF-договор и дополнительное техническое задание. Система анализирует документы, вносит изменения, объединяет информацию или формирует новую редакцию документа и возвращает результат в виде нового PDF-файла.
Аудио → Текст
Входные данные: Аудиофайл.
Выходные данные: Ответ в виде текста.
Пример использования: расшифровка аудиофайлов. Вы можете расшифровывать аудиозвонки ваших менеджеров и проводить их дальнейший анализ.
Текст → Аудио
Входные данные: Текстовый запрос.
Выходные данные: Аудиофайл.
Пример использования: Генерация аудиофайлов по тексту. Вы можете генерировать любые аудиофайлы, используя разные типы голосов, прикреплять созданные файлы к выбранным таблицам и полям, а затем либо использовать их самостоятельно (например, для озвучки роликов или аудиокниг), либо автоматизировать их отправку как сообщение в мессенджере (Telegram) для создания реалистичного диалога. Также можно использовать в связке: генерация текста в GPT - преобразование в аудио - отправка в Telegram.
Текст → Добавление строк
Входные данные: Текстовый запрос.
Выходные данные: Ответ в виде файла и автоматическое добавление новых строк в указанную таблицу.
Пример использования: Пользователь просит сгенерировать 5 фирм по установке окон с контактными данными. Система возвращает ответ в виде данных в файле и одновременно добавляет в таблицу "Поставщики" 5 новых записей. Система автоматически проведет сопоставление полей (например, "телефон", "почта", "название" из ответа GPT) и поместит нужные данные в соответствующие поля таблицы.
Текст → Заполнение записи
Входные данные: Текстовый запрос.
Выходные данные: Автоматически заполненные поля таблицы на основе анализа текста.
Пример использования:
Пользователь вводит текст, например:
«Клиент ООО "Восход" 25 сентября 2024 года заказал 35 деталей для телефона».
Система анализирует текст и автоматически заполняет соответствующие поля таблицы, например: «Клиент», «Дата заказа», «Количество», «Тип товара».
Текст → Excel
Входные данные: Текстовый запрос.
Выходные данные: Excel-файл (.xlsx).
Пример использования: Пользователь формулирует задачу в текстовом запросе, например просит создать таблицу с расчетами, структурировать данные или подготовить отчет. Система формирует Excel-файл с результатом обработки.
Excel → Текст
Входные данные: Excel-файл (.xlsx).
Выходные данные: Ответ в виде текста.
Пример использования: Пользователь загружает Excel-файл и просит проанализировать содержащиеся в нем данные, найти закономерности, выполнить расчеты или сформировать выводы. Система обрабатывает данные файла и возвращает результат в виде текста.
Excel → Excel
Входные данные: Excel-файл (.xlsx).
Выходные данные: Новый Excel-файл (.xlsx).
Пример использования: Пользователь загружает Excel-файл и задает задачу по обработке данных. Система анализирует файл, выполняет необходимые расчеты или преобразования и возвращает новый Excel-файл с результатом.
Дополнительные функции
Некоторые возможности Clientbase GPT могут использоваться как дополнительные опции для отдельных типов интеграций. Они расширяют функциональность обработки запросов и позволяют решать более сложные задачи.
Подключить Python для расчетов
Опция «Подключить Python для расчетов» позволяет использовать Python при обработке запроса. Может применяться для точных математических вычислений, сложных логических расчетов, анализа данных, обработки таблиц, моделирования сценариев.
Для использования функции необходимо включить соответствующий чекбокс в настройках интеграции.

Опция доступна для следующих типов работы:
- Текст - Текст
- Текстовый файл - Текст
- Word docx - Текст
- Word docx - Word docx
Сохранять контекст диалога
Функция «Сохранять контекст диалога» позволяет искусственному интеллекту учитывать историю предыдущих сообщений.
При включенной опции каждый следующий запрос анализируется с учетом предыдущих вопросов и ответов, что делает диалог более связным и последовательным.

Важно! Функция сохранения контекста диалога работает только в подтаблицах.
Опция доступна для следующих типов работы:
- Текст - Текст
При включении опции становятся доступны дополнительные настройки.
Связь с родительской таблицей - параметр заполняется автоматически системой и определяет связь с родительской таблицей. Изменять его не требуется.
Новый диалог через паузу (часы) - позволяет задать период времени, после которого система начнет новый диалог и перестанет учитывать предыдущий контекст. Отсчет начинается с момента последнего сообщения пользователя.
Функцию сохранения контекста можно использовать совместно с базой знаний.
Поиск по интернету
Опция «Добавить поиск по интернету» позволяет системе использовать актуальную информацию из сети при формировании ответа.
Это особенно полезно для запросов, где важна свежесть данных.
Для использования функции необходимо активировать соответствующий чекбокс в настройках интеграции.

Опция доступна для следующих типов работы:
- Текст - Текст
Продленное кэширование до 24 часов
Опция «Продленное кэширование до 24 часов» позволяет увеличить срок хранения кэша запросов к ИИ до 24 часов для поддерживаемых моделей OpenAI.
Опцию можно включить в модуле Clientbase GPT во вкладке «Настройки».
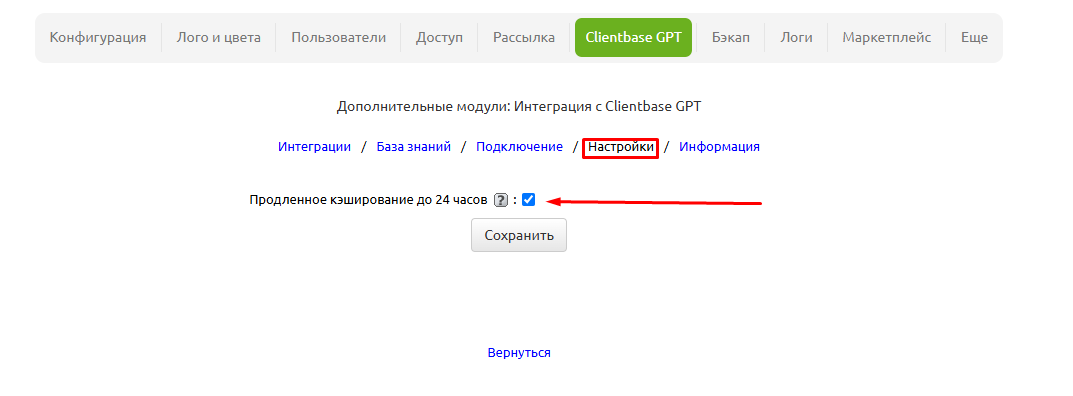
Если несколько запросов имеют одинаковое начало (статичную часть промпта) , система может использовать ранее сохраненные данные из кэша. Это позволяет сократить расход токенов и ускорить обработку повторяющихся запросов.
Наибольший эффект достигается при работе с объемными промптами, содержащими неизменяемые инструкции, большие справочники или другие повторяющиеся данные.
Для использования кэширования повторяющаяся часть промпта должна:
- содержать не менее 1024 токенов;
- располагаться в начале промпта;
- совпадать в последующих запросах.
Если совпадающего начала нет или его объем составляет менее 1024 токенов, запрос обрабатывается в обычном режиме без использования продленного кэширования.
Опция поддерживается для следующих типов работы:
- Текст → Текст
- Текстовый файл → Текст
- Текст → Текстовый файл
- Текстовый файл → Текстовый файл
- Word docx → Текст
- Word docx → Word docx
- Текст → PDF
- PDF → Текст
- PDF → PDF
- Текст → Добавление строк
- Текст → Заполнение записи
Кэширование не применяется для интеграций, связанных с обработкой изображений и аудио.
Поддерживаемые модели:
- GPT-4.1
- GPT-5
- GPT-5.1
- GPT-5.2
- GPT-5.4
Уведомление о расходе токенов
В настройках модуля Clientbase GPT можно настроить уведомление о расходе доступных токенов.
Для этого во вкладке «Настройки» включите чекбокс "Уведомление о расходе токенов" и укажите порог расхода токенов.
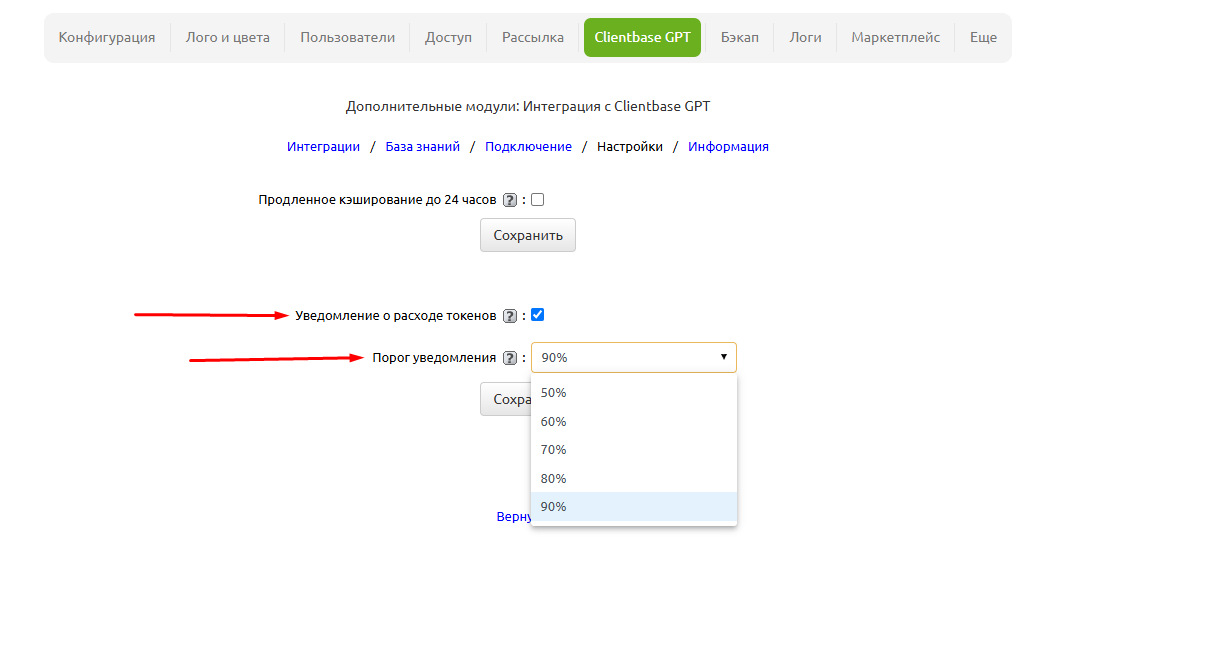
При включении система регулярно проверяет расход лимита токенов Clientbase GPT. Когда расход достигает заданного порога, администраторам создаётся внутреннее уведомление и отправляется письмо, если в аккаунте настроены SMTP-доступы и у администратора указан адрес электронной почты. При полном исчерпании лимита отправляется отдельное уведомление.
Настройка позволяет своевременно контролировать расход токенов и заранее узнать о приближении к установленному лимиту.
Пример
Рассмотрим пример - нужно сформировать описание коммерческого предложения с помощью ИИ на основе текста заявки клиента.
Для решения будем использовать:
- стандартную конфигурацию Кб
- опцию "Clientbase GPT"
- поле "Текст заявки" в таблице "Заявки"
- новое поле "Информация для КП" в таблице "Заявки"
Сделаем следующее:
- Активируем опцию
- В настройках таблицы "Заявки" добавим текстовое многострочное поле "Информация для КП", в котором будет храниться ответ ИИ
- Активируем модуль
- В настройках модуля выберем таблицу и сопоставим поля "Сообщение" и "Ответ"
В поле "Сообщение" сформируем запрос к Clientbase GPT + вставим переменные, выбранные из выпадающего списка.

Результат
В результате получим примерно следующую информацию для КП:

База знаний
Опция «База знаний» позволяет использовать данные из вашей CRM в качестве контекста для работы искусственного интеллекта. Вы можете создать несколько баз знаний, каждая из которых может включать одну или несколько таблиц. Это позволяет структурировать информацию по отделам, проектам или типам данных (например, «База клиентов», «База товаров», «База документов»). После обработки базы, ИИ будет использовать информацию из выбранной вами базы для предоставления релевантных ответов.
Базу знаний можно использовать в интеграциях с типом работы:
«Текст → Текст»
«Текст → Заполнение записи»
В этом случае информация из выбранной базы знаний будет передаваться ИИ в качестве дополнительного контекста при обработке запроса.
Функционал «Базы знаний» доступен только при активной тарифной опции Clientbase GPT.
Важно! Если при использовании функций базы знаний вы превысите лимит токенов вашего текущего тарифа Clientbase GPT, произойдёт автоматическое повышение тарифного плана на следующий.
Создание и настройка базы знаний
-
В модуле Clientbase GPT перейдите во вкладку «База знаний». Здесь отображается список всех созданных вами баз.
-
Нажмите кнопку «Добавить базу».

- В открывшемся окне заполните параметры:
Название - укажите понятное название для вашей базы знаний (например, «Клиенты и заказы»).
Таблицы - нажмите кнопку «Добавить таблицу».
В появившемся выпадающем списке выберите таблицу из вашей конфигурации.
Ниже выберите, какие поля таблицы будут включены в базу знаний:
- «Все поля» - данные будут взяты из всех полей таблицы.
- «Выбрать поля» - отметьте чекбоксами только те поля, данные из которых должны попасть в базу.
-
Нажмите кнопку «Добавить». Таблица появится в списке. Таким же способом можно добавить несколько таблиц в одну базу знаний.
-
После добавления всех необходимых таблиц нажмите кнопку «Добавить» (внизу окна настроек).

Обработка данных
После создания база появится в общем списке со статусом «Таблицы готовы к отправке» (красная иконка).

-
Перейдите в настройки созданной базы, кликнув на её название.
-
Помимо уже знакомых параметров, здесь появятся новые:
Статус — отображает текущий этап обработки данных.
Объем базы знаний - общий размер загруженных данных.
Токены (создание) - расчетное количество токенов, которые будут затрачены на первоначальную обработку и индексацию данных.
Токены (хранение) - расчетное количество токенов, затрачиваемых на ежедневное хранение базы в системе.
- В параметре «Выполнить действие» выберите опцию «Отправить на обработку» и нажмите «Сохранить».

Важно! Токены будут списаны согласно значению в поле «Токены (создание)».
Система вернет вас к списку баз. Статус изменится на «Идет обработка данных». Процесс может занять некоторое время в зависимости от объема информации.

По завершении обработки статус в настройках базы сменится на «Обработка завершена», а красная иконка в списке баз пропадет. База знаний готова к использованию.

Использование базы знаний в интеграциях
Обработанную базу знаний можно подключить к интеграции. Тогда ИИ будет искать ответы на вопросы, используя данные именно из этой базы.
- Создайте новую интеграцию с типом работы «Текст — Текст» и «Текст — Заполнение записи».

-
Заполните все необходимые параметры (таблица, поля для ответа и статуса).
-
В самом конце настроек найдите параметр «Базы знаний». В выпадающем списке выберите нужную базу из списка всех созданных вами баз.

Важно! Для одной интеграции можно выбрать только одну базу знаний. Чтобы использовать данные из нескольких таблиц, заранее добавьте их в одну общую базу.
Теперь, при срабатывании этой интеграции, ИИ будет отвечать на запросы, опираясь на информацию из выбранной базы знаний.
Обновление данных и добавление новых таблиц
Базу знаний можно обновлять вручную или автоматически по расписанию. Это позволяет поддерживать информацию в базе в актуальном состоянии при изменении или добавлении данных в исходных таблицах.
Ручное обновление
Для ручного обновления перейдите в настройки нужной базы знаний. В поле «Обновить информацию вручную» выберите необходимый вариант:
- Не обновлять — обновление базы знаний не выполняется.
- Обновить полностью — база знаний полностью перезаписывается на основе актуальных данных из подключенных таблиц.
- Добавить новое — система анализирует данные подключенных таблиц и добавляет в базу знаний только новые данные.
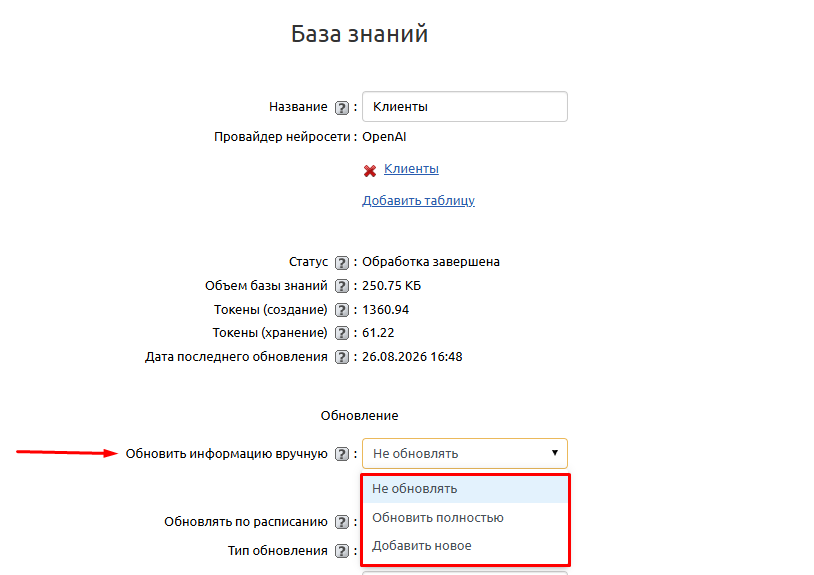
После выбора варианта сохраните настройки базы.
Обновление по расписанию
Чтобы база знаний обновлялась автоматически, включите чекбокс «Обновлять по расписанию».
После включения станут доступны дополнительные настройки:
Тип обновления — определяет, каким способом будет обновляться база:
- Добавить новое — система добавляет в базу только новые данные из подключенных таблиц.
- Обновить полностью — система полностью обновляет содержимое базы на основе актуальных данных из подключенных таблиц.
Периодичность обновления — определяет, как часто будет выполняться автоматическое обновление. Доступны следующие варианты:
- каждые 15 минут;
- каждый час;
- каждые 3 часа;
- каждые 6 часов;
- раз в день;
- раз в неделю;
- раз в месяц.
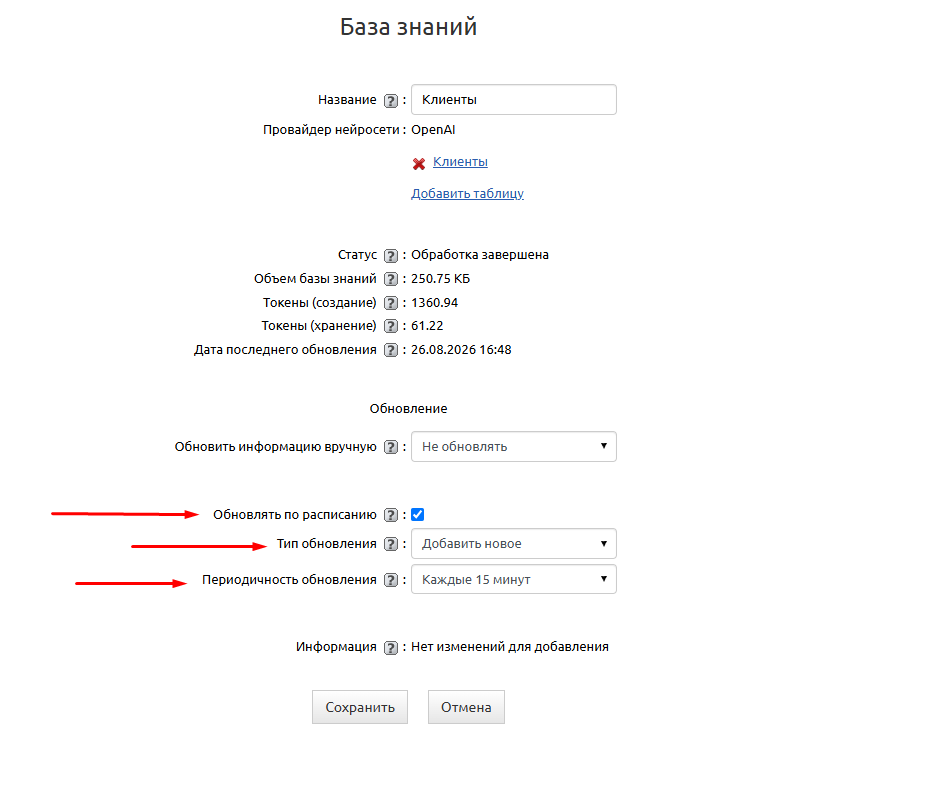
После настройки сохраните базу знаний. Далее обновление будет выполняться автоматически с выбранной периодичностью.
Добавление новой таблицы в существующую базу
- В настройках базы нажмите кнопку «Добавить таблицу» и выберите новую таблицу с нужными полями.

- Выберите действие «Отправить на обработку» и сохраните изменения.
Важно! При обновлении базы или добавлении в нее новых таблиц, будет выполнена полная обработка всей базы знаний. Система заново обработает все данные из всех подключенных таблиц, а не только новые или изменённые. На это будет затрачено соответствующее количество токенов.
Параметр «Сбросить» в поле «Выполнить действие» позволяет отменить все внесенные изменения и вернуть базу к предыдущему стабильному состоянию.

Пример использования
Задача: Отвечать на вопросы менеджеров о клиентах, используя актуальные данные из CRM.
-
Создаем базу знаний: Добавляем новую базу с названием «Наши клиенты», выбираем таблицу «Клиенты» со всеми полями и отправляем на обработку.
-
Настраиваем интеграцию: Создаем интеграцию типа «Текст — Текст» для таблицы «Вопросы от менеджеров». Заполняем все необходимые параметры интеграции. В параметре «Базы знаний» выбираем созданную базу «Наши клиенты».
-
Результат: Менеджер создает запись в таблице «Вопросы от менеджеров» с вопросом «Когда последний раз заказывал ООО "Ромашка" и на какую сумму?». ИИ проанализирует базу знаний (таблицу «Клиенты»), найдет информацию по компании «Ромашка» и сформирует точный ответ на основе реальных данных из системы.

Информация
Во вкладке "Информация" отображаются сведения о текущем использовании тарифной опции:
Лимит токенов - показывает, сколько токенов уже использовано из общего доступного лимита.
Дата следующего обновления токенов - дата, когда произойдет автоматический сброс счетчика использованных токенов.
Опция - название подключенной тарифной опции Clientbase GPT в личном кабинете.
Для обновления отображаемой информации предусмотрена кнопка "Обновить информацию".

Использование шаблонизатора в промптах
Помимо подстановки отдельных полей, в промптах можно использовать шаблонизатор, аналогичный применяемому в шаблонах печати. Это позволяет формировать запросы к ИИ с использованием условий, циклов и других конструкций Smarty.
Работа с подтаблицами
Для перебора записей подтаблицы используйте цикл foreach.
Например, если к таблице «Счета» подключена подтаблица «Позиции счета», можно сформировать список товаров следующим образом:
{foreach from={Позиции счета}}
- {Позиции счета.Наименование}
{/foreach}
Также внутри цикла можно обращаться к любым полям записей подтаблицы:
{foreach from={Позиции счета}}
{Позиции счета.Наименование} — {Позиции счета.Количество} шт.
{/foreach} 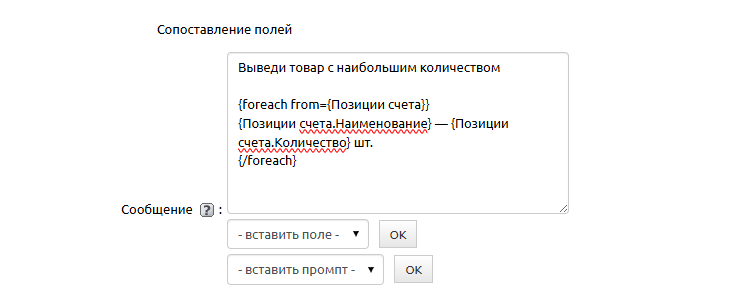
Использование условий
Для формирования различных частей промпта в зависимости от данных записи используйте оператор if.
Например:
{if {Итого к оплате} > 100000}
Обращайся к клиенту максимально вежливо и официально.
{/if}
Поддерживаются также конструкции else и elseif:
{if {Итого к оплате} > 100000}
Крупный заказ.
{elseif {Итого к оплате} > 50000}
Средний заказ.
{else}
Небольшой заказ.
{/if}
Обработка пустых подтаблиц
Для вывода текста при отсутствии записей в подтаблице можно использовать конструкцию foreachelse:
{foreach from={Позиции счета}}
- {Позиции счета.Наименование}
{foreachelse}
Позиции отсутствуют.
{/foreach}
Вложенные конструкции
Условия можно использовать внутри циклов. Например, выводить только позиции, удовлетворяющие определенному условию:
{foreach from={Позиции счета}}
{if {Позиции счета.Количество} > 5}
- {Позиции счета.Наименование}
{/if}
{/foreach}
Отличия от стандартного Smarty
При использовании шаблонизатора в Clientbase GPT следует учитывать следующие особенности:
названия полей и подтаблиц указываются в фигурных скобках без символа $;
цикл foreach записывается в сокращенной форме:
{foreach from={Позиции счета}} В остальном синтаксис соответствует возможностям шаблонизатора, используемого в шаблонах печати.
Особенности и ограничения
- Модуль поддерживает следующие модели:
OpenAI:
- Флагманская модель GPT-5.6 Sol
- Сбалансированная модель GPT-5.6 Terra
- Облегчённая и экономичная модель GPT-5.6 Luna
- Флагманская модель GPT-5.4
- Оптимизированная модель GPT-5.4-mini
- Облегчённая и быстрая модель GPT-5.4-nano
- Флагманская модель GPT-5.2 (максимальное качество)
- Флагманская модель GPT-5
- Улучшенная версия GPT-5.1
- Оптимизированная модель GPT-5-mini
- Облегчённая и быстрая модель GPT-5-nano
- Высокоуровневая модель GPT-4o
- Низкоуровневая модель GPT-4o-mini
- Универсальная модель GPT-4.1
- Оптимизированная модель GPT-4.1-mini
- Облегчённая модель GPT-4.1-nano
Yandex:
- YandexGPT 5.1 Pro
- YandexGPT 5 Pro
- YandexGPT 5 Lite
- Alice AI LLM
- Qwen
-
На текущий момент не поддерживается входные и выходные параметры в виде файлов Гугл Докс.
-
В случае ошибки при генерации ответа в логах можно увидеть ответ, содержащий код 400.
Важно! Для отображения ошибок, связанных с интеграцией во вкладке "Настройки лога" должен быть включен чекбокс "интеграция").
Тарифные коэффициенты моделей GPT
Коэффициент показывает, какое количество токенов будет списано с баланса при обращении к модели. Например, для gpt-4o-mini действует соотношение 1:1, а для gpt-5.2 — 1:20. Это означает, что один и тот же запрос при использовании более мощной модели обойдётся примерно в 20 раз дороже.
Поэтому клиенту важно подбирать модель экспериментально, исходя из конкретных задач. Оптимальный подход — начать с более простой и экономичной модели, оценить качество результата и переходить на более высокий уровень только в случае, если возможностей базовой модели недостаточно.
Использовать всегда только самые дешёвые или, наоборот, только самые дорогие модели нерационально: эффективнее находить баланс между стоимостью и качеством в зависимости от сценария.
|
Команда |
Модель |
Коэффициент |
Стоимость решения усредненной задачи, руб |
Описание модели |
| Текст-текст | gpt-4o-mini | 1 | 0.09 | Быстрая, экономичная, подходит для простых запросов, чат-ботов и ежедневного использования. |
| Текст-текст | GPT-5.6 Sol | 43.75 | 3.94 | Продвинутая модель для наиболее сложных аналитических и интеллектуальных задач, где приоритетом является качество результата. |
| Текст-текст | GPT-5.6 Terra | 17.5 | 1.575 | Сбалансированная модель для сложных бизнес-задач, требующих высокого качества анализа при умеренной стоимости. |
| Текст-текст | GPT-5.6 Luna | 1.75 | 0.1575 | Быстрая и экономичная модель для повседневных задач, где важна минимальная стоимость. |
| Текст-текст | gpt-4o | 16 | 1.44 | Идеальна для большинства бизнес-задач: анализ текстов, создание контента, поддержка. |
| Текст-текст | gpt-5.4 | 22.5 | 2.025 | Флагманская модель для самых сложных аналитических, творческих и исследовательских задач. |
| Текст-текст | gpt-5.4-mini | 6.5 | 0.585 | Оптимальный баланс между мощностью GPT-5.4 и доступной ценой для большинства бизнес-задач. |
| Текст-текст | gpt-5.4-nano | 1.825 | 0.16425 | Максимально легкая и быстрая версия для простых повседневных задач с минимальными затратами. |
| Текст-текст | gpt-5.2 | 20 | 1.8 | Для сложных аналитических и творческих задач. |
| Текст-текст | gpt-5 / gpt-5.1 | 15 | 1.35 | Для стратегического анализа, сложных вычислений и экспертных ответов. |
| Текст-текст | gpt-5-mini | 3 | 0.27 | Хороший баланс между GPT-5 качеством и доступной ценой для повседневных задач. |
| Текст-текст | gpt-5-nano | 0.55 | 0.0495 | Для максимально бюджетных решений с базовым качеством. |
| Текст-текст | gpt-4.1 | 18.75 | 1.6875 | Стабильная и проверенная модель. Особенно хороша для технических текстов и задач, требующих высокой точности. |
| Текст-текст | gpt-4.1-mini | 5 | 0.45 | Компактная версия GPT-4.1. Достаточно мощная для большинства задач, но дешевле флагмана. |
| Текст-текст | gpt-4.1-nano | 1.25 | 0.1125 | Для простейших задач, где важна в первую очередь экономия. |
| Текст-текст | YandexGPT 5 Lite | 6.58 | 0.59175 | Быстрая и экономичная модель для ежедневных задач. |
| Текст-текст | YandexGPT 5 Pro | 39.50 | 3.555 | Продвинутая модель для сложных бизнес-задач, анализа информации. |
| Текст-текст | YandexGPT 5.1 Pro | 39.50 | 3.555 | Улучшенная версия YandexGPT Pro с более точным пониманием контекста. |
| Текст-текст | Alice AI LLM | 39.50 | 3.555 | Мощная языковая модель Яндекса для интеллектуальных ассистентов, диалоговых сценариев и сложных пользовательских запросов. |
| Текст - Изображение | dalle (устаревшая) | 100000 | 20 | Устаревшая модель генерации изображений. Поддерживается для совместимости со старыми проектами. |
| Текст - Изображение | gpt-image-1.5 low | 25000 | 5 | Достаточно для иконок, простых иллюстраций и визуализации идей. |
| Текст - Изображение | gpt-image-1.5 medium | 100000 | 20 | Для большинства коммерческих задач: реклама, соцсети, презентации. |
| Текст - Изображение | gpt-image-2 low | 15000 | 3 | Быстрая генерация изображений базового качества. Подходит для прототипов, иконок и черновиков. |
| Текст - Изображение | gpt-image-2 medium | 137500 | 27.5 | Высокое качество для коммерческих задач: рекламные креативы, презентации, контент для соцсетей. |
| Текст - Изображение | gpt-image-2 high | 525000 | 105 | Максимальная детализация и фотореализм. Для арт-проектов, премиум-графики и профессионального дизайна. |
| Текст - Изображение | gpt-image-1.5 high | 400000 | 80 | Фотографическая детализация, арт-проекты, коммерческая графика премиум-класса. |
| Изображение - Текст | gpt4o-mini | 62.5 | 0.5 | Базовый анализ изображений. Распознавание текста, простые объекты, основные сцены. Экономичный выбор. |
| Изображение - Текст | GPT-5.6 Sol | 2125 | 17 | Продвинутая модель для сложного анализа визуальной информации, требующего высокой точности и глубокого понимания контекста. |
| Изображение - Текст | GPT-5.6 Terra | 425 | 3.4 | Сбалансированная модель для детального анализа изображений, документов, схем и визуального контекста. |
| Изображение - Текст | GPT-5.6 Luna | 42.5 | 0.34 | Экономичная модель для быстрого анализа изображений, распознавания текста и простого визуального анализа. |
| Изображение - Текст | GPT-4.1 | 850 | 6.8 | Продвинутый анализ. Детальное описание сцен, анализ сложных изображений, технических схем. |
| Изображение - Текст | GPT-5 | 525 | 4.2 | Понимание контекста, эмоций на фото, сложных визуальных взаимосвязей. |
| Изображение - Текст | GPT-5 Mini | 107.5 | 0.86 | Хорошее качество распознавания по разумной цене. |
| Изображение - Текст | GPT-5 Nano | 21.25 | 0.17 | Быстрый анализ. Для простейшего распознавания объектов и текста на изображениях. |
| Аудио - Текст | whisper | 15000 | 15 | Преобразование речи в текст с высокой точностью, поддержка разных языков и акцентов. |
| Аудио - Текст | gpt-4o-transcribe | 15000 | 15 | Продвинутая модель транскрибации с высоким качеством распознавания сложной речи и терминов. |
| Аудио - Текст | gpt-4o-mini-transcribe | 7500 | 7.5 | Экономичная модель для быстрой расшифровки аудио с базовым качеством распознавания. |
| Текст - Аудио | tts-1 | 575 | 6.9 | Стандартный синтез речи. Естественное звучание для аудиосообщений, подкастов, озвучки контента. |
| Текст - Аудио | tts-1 hd | 1125 | 13.5 | Кристально чистое звучание для проектов, аудиокниг, рекламы. |
| RAG - эмбендинг | text-embedding-3-small | 0.05 | 250 | Размер 1536, хороший baseline, достаточно для большинства CRM задач. Усредненная задача высчитана из условий 100Мб базы текста. |
| RAG - эмбендинг | text-embedding-3-large | 0.325 | 1625 | Размер 3072, лучше понимает смысл, особенно на сложных текстах, юридических, длинных письмах, многоязычности. Усредненная задача высчитана из условий 100Мб базы текста. |
| RAG - хранение | Vector Store storage | 250 | 150 | Хранение векторных данных. Усредненное значение это база 100Мб * 30 дней. |
